AegisMonitor
🛡️ Aegis Monitor
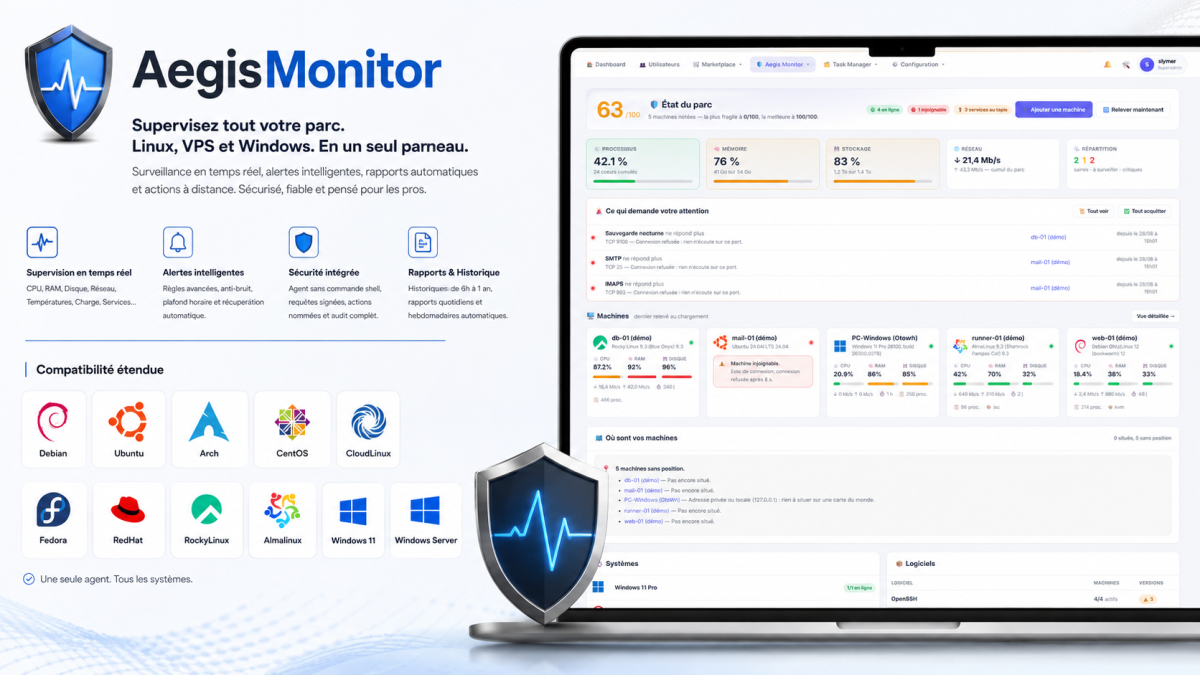
La supervision de parc, intégrée à votre back-office. Serveurs Linux, VPS et postes Windows dans un seul panneau, pilotés par un agent qui ne reçoit jamais de commande shell.
Ce qui est inclus
Un agent, pas neuf
Un seul fichier Python, bibliothèque standard seule, qui détecte le système au démarrage et choisit son collecteur. Debian, Ubuntu, CentOS, RedHat, CloudLinux, Fedora, Arch, Rocky, AlmaLinux — elles partagent le même noyau et le même systemd. Windows 11, Server 2022 et 2025 par le même fichier.
Le panneau n'a jamais de shell sur la machine
Requêtes signées en HMAC-SHA256, fenêtre de rejeu de 300 secondes, et une liste fermée de 23 actions nommées : le panneau demande metrics, l'agent décide seul de ce que cela veut dire.
C'est la frontière de sécurité, pas une politesse.
Relevés en direct
Processeur, mémoire, disques, réseau, températures, charge, processus, temps de service. Historique de 6 h à 1 an, avec repliement automatique en moyennes horaires au-delà de 30 jours : une machine relevée chaque minute produit 1 440 lignes par jour, et la tendance compte alors plus que la minute.
Alertes qui ne crient pas pour rien
Règles de seuil sur neuf mesures, par machine ou pour tout le parc, avec trois garde-fous :
| Garde-fou | Ce qu'il évite |
|---|---|
| Le seuil doit tenir sur N relevés consécutifs | Une pointe de trois secondes pendant une sauvegarde n'est pas une surcharge |
| Un repos entre deux rappels | Un disque plein le reste |
| Le rétablissement est annoncé | Se lever la nuit pour un incident déjà résolu |
Le silence a son propre chemin
Une machine muette ne produit aucune mesure : aucune règle de seuil ne peut la voir, faute de quelque chose à comparer. C'est pourtant le symptôme le plus grave.
Plafond horaire d'envoi
Une règle mal réglée peut expédier six cents messages en une nuit — l'expéditeur finit classé en indésirable, et les vraies alertes avec lui. Au plafond, l'envoi s'arrête et le journal l'inscrit : un silence invisible serait indiscernable de « rien à signaler ».
Rapports quotidien et hebdomadaire
Ils partent même quand tout va bien. Recevoir « 12 machines, rien à signaler » prouve que la chaîne fonctionne ; un rapport qui ne partirait qu'en cas de problème serait indiscernable d'un rapport en panne.
Sondes de service
« Ce port répond-il ? » — TCP, UDP, HTTP, HTTPS — exécutées depuis la machine elle-même. Un service qui écoute sur 127.0.0.1 est invisible de l'extérieur sans que ce soit une panne ; un pare-feu peut couper la vue du panneau alors que tout va bien. Onze modèles prêts, et plusieurs échecs consécutifs exigés avant de déclarer la panne.
Note sur 100
Pondérée sur cinq critères. Un critère non mesuré est retiré du total, pas noté zéro : un zéro serait un jugement, pas une mesure.
Console armée et auditée
Éteinte par défaut, armée quinze minutes après avoir retapé le nom de la machine, chaque commande journalisée. L'écran dit franchement que ce n'est pas un vrai terminal, et ne propose que les commandes du système en face.
Étiquettes libres et actions groupées
web, prod, rennes. Neuf actions sur une sélection, résultat rendu machine par machine : « 38 sur 40 » ne dit pas lesquelles ont échoué.
Et aussi
- Inventaire logiciel
- Mises à jour avec console en direct
- Redémarrage à distance
- Changement de port SSH
- Surveillance des tentatives d'authentification
- Carte du monde
- Détection du type de matériel (portable, fixe, station, serveur, VPS, conteneur) lue dans le SMBIOS
- Journal général du parc : recherche plein texte, filtres, export CSV, acquittement — l'incident vu quitte les alertes mais reste au journal
- Assistant IA avec huit consultations au format JSON — analyse de charge, sécurité, capacité, incident
Ce qu'Aegis Monitor ne fait pas — et l'assume
Il ne remplace pas Zabbix ni Netdata. Ceux-là sont gratuits, plus complets, et se déploient sur des milliers de nœuds. L'argument ici est autre : c'est dans votre back-office, avec vos autres modules, sans second outil à administrer.
Il ne lit pas les capteurs internes du processeur sous Windows. HWiNFO les obtient par l'interface SMI en mode SMM, ce qui exige un pilote en mode noyau — qu'un agent de supervision n'a pas à installer. Et quand une sonde rend une valeur figée, elle est écartée plutôt qu'affichée : on croirait surveiller, on ne surveillerait rien.
Il ne fait pas de découverte réseau automatique, ni de prédiction de panne par IA. Ça se démontre bien et ça ne sert jamais.
Supervision et administration de serveurs Linux et Windows : ressources en temps réel, sondes de service, alertes et rapports par courriel, étiquettes et actions groupées, inventaire logiciel, sécurité, mises à jour, note sur 100 et assistant IA.
▧ Taille de l'archive : 613 Ko
Aucun avis pour ce produit. Soyez le premier !
Connectez-vous pour laisser un avis
Se connecter